做一个视频,不需要视频模型
You Don't Need a Video Model to Make a Video
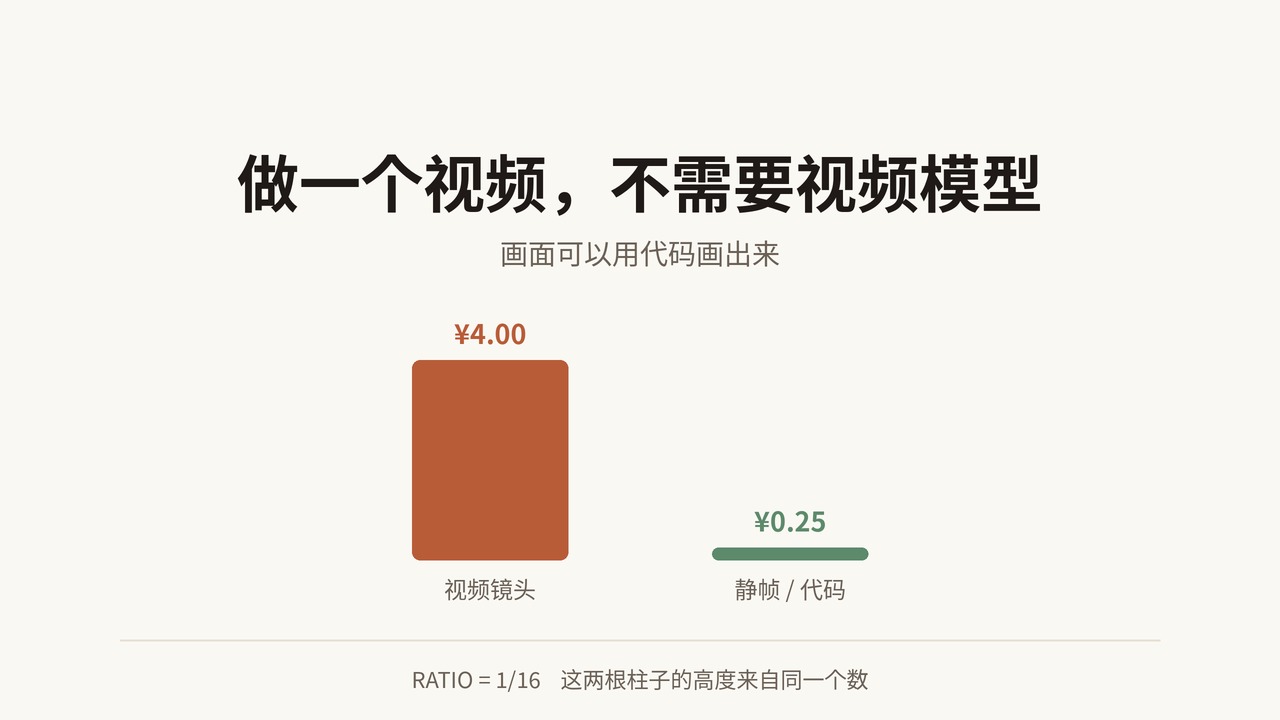
想做个视频,大多数人的第一反应是去找视频生成模型。
然后被价格劝退。
其实对于讲道理、讲知识这类内容,九成的镜头根本不需要视频模型。
再往前走一步:很多时候,连生图模型也不需要。
一
先把一个视频拆开。它只有三样东西:画面、声音、字幕。
声音是文本转语音,几分钱。字幕是把旁白切片,顺着音频时长排时间轴,不花钱。贵的只有画面。
而讲知识的视频,画面上真正出现的是什么?是柱子、是流程、是几个方框和箭头、是一个数字从零涨到五十。
这些东西本来就是算出来的,不是画出来的。
交给生图模型,它得猜”十六倍看起来像什么”。交给代码,十六倍就是 1 和 1/16。
二
但省钱不是重点。
代码画画面,真正的好处是:「画面和旁白对不上」这个失败模式,从构造上消失了。
这是我做视频砸得最多的地方。旁白在讲一个道理,画面上摆着一个风马牛不相及的东西。根源是生成模型只画字面——你在提示词里写”仿佛象征着”,那是写给人看的注解,它不读。
而代码不会。旁白说”差十六倍”,那两根柱子的高度就是同一个数算出来的。它们不可能不一致,因为它们是同一个事实的两种输出。
有个镜头可以说明这件事:我想讲”观众感知到的动,是镜头在动,不是画面里的东西在动”。代码版里,那张底图整镜一个像素都没变,只有取景框在推近。
这个论点,生图模型演示不了——它每一帧都在重新画。
三
第二个好处是确定性。
生图是抽卡。不满意就重跑,重跑要花钱、要等几分钟,而且结果是另外一批图,不是”同一批但改好的那张”。
代码是同样输入永远同样输出。改一个数字,几秒钟重渲染,其余部分一帧不变。它能进 git,能 diff,能回滚。
四
该说代价了。
这一版的画面成本是零,比生图版省了三块五。
但我为此多写了七百行代码,多花了大约两倍半的模型开销。
单看这一次,代码路线更贵,不是更便宜。
它划算的地方在第二次。渲染层和合成脚本写完就不动了,下一个视频只换场景函数。边际成本从那里开始掉。
所以正确的说法不是”代码比生图便宜”,而是:一次性的用生图,要反复出同一类片子的建代码管线。
五
还得说清楚它不擅长什么。
代码画不出一只手按在胶片上的质感,画不出黄昏的光,画不出情绪。它擅长的是数字、比例、流程、几何——凡是能被算出来的东西。
需要质感和情绪的镜头,老老实实用生图。两条路不是谁取代谁。
六
最后是三个坑,都是不报错的那种。
第一个:ffmpeg 的 -shortest 配上音频流复制,静默吃掉了六十二帧。成片的容器时长写着一百零六秒,视频流其实只有一百零三秒,结尾两秒半没有画面。
第二个:mp3 的容器时长比它解码出来的样本长约五十毫秒。按容器时长排时间轴,十四个镜头累计差掉零点七七秒,字幕整体往后漂。
第三个:烧录字幕时,字幕引擎默认的参考分辨率是二百八十八。你写字号十九,它渲染出来是八十四像素。
这三个的共同点是:不看就发现不了。 它们不抛异常,不打警告,成片能播。只能靠数帧数、对时长、抽帧去看。
这篇文章配了一个视频。它的每一帧——包括上面那张封面——都是代码画出来的。
画面成本是零。
💬展开评论 / Show comments